Publicado: agosto 26, 2026
Pruebas paralelas bien hechas: por qué falla tu pipeline (y cómo solucionarlo)
Todo tester de control de calidad conoce la frustrante sensación de ver crecer un conjunto de automatización con el tiempo. Lo que comienza como una ágil prueba de humo de 5 minutos se convierte gradualmente en una extensa ejecución de 2 horas. Cada nueva función trae consigo varios scripts móviles de Appium o flujos de navegador de Selenium adicionales; en poco tiempo, los desarrolladores están impacientes, los gestores de lanzamientos piden actualizaciones y el control de calidad se ve estigmatizado con una etiqueta incómoda: el cuello de botella de la entrega.
Entonces abres la configuración de tu marco de pruebas, ves la configuración para la ejecución concurrente y piensas: "¿Por qué no?".
Enciendes el interruptor y vuelves a ejecutar el programa. Lo que debería ser una mejora de velocidad se convierte en una compilación plagada de fallos inexplicables.
Tres horas después, vuelves a ejecutar la misma confirmación. Pasa. Esperas a la siguiente compilación. Otras dos pruebas fallan. Te preguntas si estás perdiendo la cabeza.
En realidad no has acelerado tu proceso. Has construido un costoso generador de fallos aleatorios de alta velocidad.
El problema: El mito del interruptor paralelo
Una gran idea errónea en la automatización de pruebas moderna es que pasar de las pruebas secuenciales a las pruebas paralelas es solo un simple ajuste de configuración. No lo es; es un un cambio arquitectónico fundamental.
Cuando se ejecutan las pruebas de forma secuencial, se comportan como conductores educados en una carretera de un solo carril. Una prueba se ejecuta, finaliza su ejecución y se aparta para que la siguiente pueda comenzar. Todo se mantiene ordenado porque solo ocurre una cosa a la vez.
Cuando activas el modo paralelo sin modificar tu conjunto de pruebas subyacente, tomas a esos mismos conductores, los dejas en una caótica autopista de cuatro carriles sin semáforos y te preguntas por qué se produce un choque múltiple inmediato.
De repente, las pruebas que se ejecutaban correctamente de una en una comienzan a fallar aleatoriamente ahora que se ejecutan en paralelo, con crípticos tiempos de espera de elementos, conexiones de controladores rotas o terminaciones de sesión inesperadas. Vuelves a ejecutar la compilación en Jenkins y las pruebas que fallaron pasan. En cambio, fallan otras tres pruebas. Bienvenidos al Heisenbug.
Por qué falla: Los cuatro culpables
¿Por qué las pruebas que se ejecutan correctamente de forma secuencial fallan en el momento en que se ejecutan en paralelo? Casi siempre se reduce a un principio: pruebas pisándose los talones unos a otros.
La investigación sobre la inestabilidad de las pruebas clasifica estos fallos en distintas categorías. Según una revisión bibliográfica publicada en la 37.ª Conferencia Internacional IEEE/ACM sobre Ingeniería de Software Automatizada (ASE '22), las pruebas inestables suelen tener tres orígenes: inestabilidad basada en la prueba (scripts defectuosos, identificadores inestables, esperas asíncronas, pruebas dependientes del orden), inestabilidad basada en el entorno (condiciones de red, contención de recursos, conflictos entre múltiples entornos) e inestabilidad basada en el producto (condiciones de carrera y fugas de memoria en la propia aplicación). Los cuatro problemas que se describen a continuación son manifestaciones prácticas y cotidianas de estas categorías en un conjunto de pruebas paralelas.
Colisiones de datos: dos pruebas, un registro
Imaginemos que dos personas editan simultáneamente la misma celda de una hoja de cálculo. Si la Prueba A actualiza un perfil de usuario (user_id: 101) mientras que la Prueba B elimina simultáneamente el mismo usuario (user_id: 101), una de ellas fallará. Ninguna de las pruebas estaba mal escrita; simplemente coincidieron en el mismo dato.
En un mundo paralelo, esta colisión se produce a gran escala. Un equipo que ejecuta muchas pruebas simultáneamente en una base de datos de prueba compartida tiene muchas probabilidades de toparse con este obstáculo tarde o temprano.
Filtraciones de controladores: Compartiendo el control remoto
Ya sea para controlar un navegador con Selenium o una aplicación móvil con Appium, su script necesita su propia sesión de controlador dedicada. Un error común es compartir accidentalmente un controlador estático entre hilos:
// Antipatrón: Controlador compartido entre hilos paralelos
público estático controlador WebDriver;
@Prueba
público vacío pruebaA() {
conductor.obtener(“https://ejemplo.com”);
conductor.findElement(By.id("enviar")).hacer clic();
}
@Prueba
público vacío pruebaB() {
conductor.findElement(By.id("nombre de usuario")).sendKeys("administración");
// Ups: testA podría estar en una página diferente ahora mismo.
}
Es como si dos personas se pelearan por un control remoto de televisión; un trabajador cambia de página mientras el otro está haciendo clic. Un caos.
Incluso en Playwright, no lograr aislar Contexto del navegador Las instancias permiten que las cookies y las sesiones de inicio de sesión se propaguen entre pruebas concurrentes:
// Antipatrón: Contexto compartido en Playwright
const contexto compartido = await cada navegador.nuevoContexto();
// Varias pruebas usan sharedContext; las sesiones se superponen.
La solución: usar Hilo local (Java) o aislamiento de contexto por trabajador (JavaScript/Dramaturgo).
Contaminación del estado BDD: La trampa del pepino
Los frameworks como Cucumber son excelentes para escribir pruebas en lenguaje natural. Sin embargo, los ingenieros de automatización suelen almacenar el estado del escenario en variables globales:
// Antipatrón: Estado de paso compartido en Cucumber
público estático Usuario registrado;
@Dado(“Un usuario ha iniciado sesión”)
público vacío usuarioIniciadoSesión() {
Usuario registrado = ¡nuevos Socios! de Usuario(“alice@example.com");
}
@Cuando(“el usuario realiza un pedido”)
público vacío orden de lugar() {
// El hilo A podría haber sobrescrito a logindUser
}
Cuando se ejecuta en paralelo, el hilo A sobrescribe silenciosamente Usuario registrado mientras el Hilo B está a mitad de camino de verificar una página de pedido, lo que desencadena errores de aserción aleatorios. La solución: usar Inyección de dependencia (PicoContainer, Spring) de modo que cada instancia de escenario posee sus propios objetos de estado.
La trampa de los "sobrantes": datos y dispositivos huérfanos
La principal causa de fallos en las canalizaciones paralelas es la falta de limpieza. Cuando una prueba falla a mitad de su ejecución, omite su limpieza y deja "datos huérfanos": un carrito de compra bloqueado, una dirección de correo electrónico duplicada o un dispositivo que no se reinicia correctamente antes de que la siguiente prueba lo utilice.
Esto se aplica tanto a los dispositivos de prueba físicos como virtuales, así como a los datos. En una red de dispositivos compartidos, una prueba que no realiza la limpieza posterior (estado residual de la aplicación, credenciales almacenadas en caché, instalaciones de aplicaciones obsoletas) puede corromper silenciosamente la siguiente prueba que se ejecute en ese dispositivo. Digital.ai Guía de mejores prácticas de Appium para pruebas Aborda este problema directamente, cubriendo métodos de prueba independientes, evitando variables estáticas y mediante una gestión adecuada de los controladores en ejecuciones paralelas, junto con la limpieza de los dispositivos entre sesiones para mantener la red en un estado óptimo conocido.
En un entorno secuencial, es posible que no te importe dejar un desorden atrás porque la siguiente prueba analiza otra cosa. En un entorno paralelo, otro hilo de trabajo llega a ese desorden tres segundos después y falla. Esto crea un efecto en cascada; una prueba mal ejecutada puede provocar fallos en varias pruebas posteriores.
El costo: La falta de fiabilidad como impuesto oculto
Cuando un conjunto de pruebas paralelas se vuelve inestable, el daño va mucho más allá de los indicadores rojos en un panel de control. Socava fundamentalmente la cultura del equipo y consume recursos.
Matemáticas de la probabilidad compuesta
Consideremos las matemáticas de una canalización paralela. Si un conjunto de pruebas de interfaz de usuario tiene un pequeño Tasa de desprendimiento de escamas del 1%Ejecutar 50 de esas pruebas de forma secuencial te da una buena probabilidad de ver una compilación exitosa.
Sin embargo, cuando esas 50 pruebas se distribuyen entre 8 procesos paralelos que se ejecutan simultáneamente, esa tasa de fallos del 1 % se agrava. Esto es probabilidad básica, no una estadística industrial reconocida; es una explicación matemática para demostrar por qué la inestabilidad empeora, en lugar de mejorar, al paralelizar las operaciones.
| Trabajadores paralelos | Tasa de aprobación acumulada | Tasa de falsos fallos |
| 1 (secuencial) | 99.5% | 0.5% |
| 2 | 98.0% | 2.0% |
| 4 | 96.1% | 3.9% |
| 8 | 92.3% | 7.7% |
| 16 | 85.2% | 14.8% |
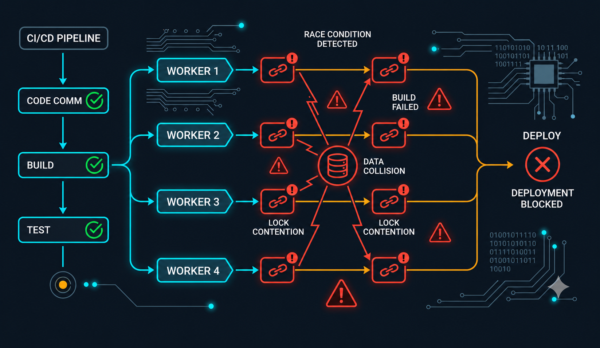
La cascada: Varios procesos desencadenan condiciones de carrera (colisiones de datos, contención de bloqueos, sesiones huérfanas), lo que provoca que la compilación falle aunque no haya ningún código defectuoso. Los desarrolladores vuelven a ejecutar el proceso hasta que dan con una combinación exitosa.
Fatiga por alertas y la cultura de la repetición
Cuando un conjunto de pruebas falla aleatoriamente, los equipos de ingeniería sufren fatiga por alertas. Como señala la revisión bibliográfica de ASE '22 sobre la inestabilidad de las pruebas, los desarrolladores junior, en particular, "tienden a ignorar los casos de prueba inestables o a repetirlos hasta que pasan, lo que permite que fallos potencialmente peligrosos no se reporten". La misma investigación señala que investigar la causa raíz de la inestabilidad consume mucho tiempo y que el costo se desperdicia por completo si la inestabilidad resulta ser una falsa alarma; una dinámica que desalienta a los equipos a profundizar y fomenta el hábito de "simplemente volver a ejecutarlo".
Cada repetición de una suite paralela consume tiempo de cómputo real y presupuesto de la red en la nube. El coste exacto varía según el tamaño del equipo, la duración de la suite y el precio de la infraestructura, pero la tendencia es predecible: los equipos que no solucionan los problemas de aislamiento subyacentes tienden a pagar repetidamente, tanto en tiempo de ingeniería como en gastos de infraestructura, por un problema que el aislamiento habría evitado.
Los patrones: Construyendo mundos de prueba aislados
Para evitar que las pruebas paralelas entren en conflicto, hay que impedir que compartan recursos. Cada ejecutor de pruebas debe operar dentro de su propio entorno aislado.
Infraestructura efímera: El patrón contenedor
En lugar de dirigir todos los procesos paralelos a una única base de datos de preparación, los equipos modernos utilizan entornos efímeros con contenedores. Con Docker, se puede crear un contenedor de base de datos aislado y dedicado para cada hilo de trabajo sobre la marcha, eliminándolo en cuanto finaliza la prueba. Los ejecutores de CI basados en Kubernetes van aún más allá, programando entornos de prueba desechables completos para cada ejecución del pipeline.
Para pruebas móviles y web a gran escala, Digital.ai Pruebas Proporciona una red en la nube de dispositivos reales para ejecutar pruebas de Appium, Selenium y pruebas entre navegadores en paralelo, con limpieza del dispositivo entre sesiones para que la siguiente prueba comience desde un estado limpio conocido en lugar de heredar datos o configuración de la aplicación sobrantes de la ejecución anterior.
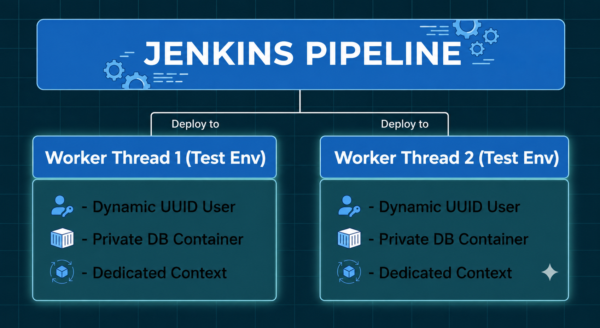
Cada hilo de trabajo en su canalización de Jenkins recibe su propio entorno aislado: usuarios de prueba dinámicos basados en UUID, contenedores de bases de datos Docker privados y contextos de navegador/dispositivo dedicados.
Zonificación del contexto del navegador y del dispositivo
Para Selenium, la solución es thread-safe Asignación de conductores:
// Patrón: aislamiento del controlador ThreadLocal
de inversores privados estático final Hilo local driverThread = ¡nuevos Socios! de ThreadLocal<>();
público estático WebDriver getDriver() {
if (driverThread.get() == nulo) {
driverThread.set(¡nuevos Socios! de ChromeDriver());
}
volvemos driverThread.get();
}
@Después del método
público vacío demoler() {
Controlador WebDriver = driverThread.get();
if (conductor != nulo) {
conductor.salir();
driverThread.remove();
}
}
Para Appium, asegúrese de que su cuadrícula aprovisione dinámicamente instancias de dispositivos prístinas y no compartidas por hilo. Cada trabajador debe tener su propia Controlador de Appium sesión con un único ID de sesióny el dispositivo subyacente debe reiniciarse antes de que la siguiente sesión lo solicite.
Este es exactamente el tipo de higiene de dispositivos que Digital.ai Pruebas Está diseñado para admitir lo siguiente: su script de prueba es responsable de llamar a quit() al final de cada sesión, y la plataforma lo respalda con su propio ciclo automatizado de limpieza de dispositivos entre sesiones, de modo que el siguiente trabajador paralelo siempre obtiene un dispositivo que se sabe que está limpio, independientemente de lo bien que cualquier prueba individual haya limpiado después de sí misma. Combinado con la guía en Digital.ai Mejores prácticas para la ejecución paralela de pruebas Al evitar las variables estáticas y mantener la independencia de los métodos de prueba, se garantiza que cada dispositivo se encuentre en un estado óptimo conocido entre ejecuciones.
En Dramaturgo, abraza Contexto del navegador objetos: cada contexto actúa como una ventana de incógnito aislada, por lo que los tokens y el almacenamiento nunca se filtran entre ejecuciones concurrentes.
// Patrón: Contexto de dramaturgo aislado por prueba
const cada navegador = await cromo.lanzamiento();
const contexto1 = await cada navegador.nuevoContexto();
const contexto2 = await cada navegador.nuevoContexto();
// Cada contexto tiene sus propias cookies, almacenamiento local y almacenamiento de sesión.
Generación de datos sintéticos: El escudo UUID
¿Cómo evitar colisiones de datos sin reinicios complejos de la base de datos? Un método fiable consiste en utilizar identificadores únicos generados en tiempo de ejecución (UUID), de modo que los procesos paralelos se ejecuten simultáneamente en el mismo entorno sin acceder nunca al mismo registro.
// Patrón: datos sintéticos basados en UUID
@Prueba
público vacío testCheckout() {
String uniqueUserId = UUID.randomUUID().toString();
Usuario usuario = ¡nuevos Socios! de Usuario(uniqueUserId + "@ejemplo.com", uniqueUserId);
// El hilo A utiliza usuario-a1b2c3d4@example.com
// El hilo B utiliza usuario-x9y8z7w6@example.com
// Sin colisiones
}
Al combinar la generación de datos sintéticos con entornos efímeros y autolimpiables, los equipos eliminan por completo las dependencias de las pruebas. Las pruebas ya no compiten por un estado compartido; cada una se ejecuta sobre su propio conjunto de datos limpio y creado dinámicamente. Para obtener más información sobre cómo crear este tipo de canalización, incluidos los datos de prueba generados por IA y la limpieza automatizada del entorno, consulte Guía para desarrolladores sobre la generación de datos sintéticos y entornos de prueba autolimpiables..
El manual de estrategias: una hoja de ruta minimalista
Refactorizar un conjunto de herramientas heredado para su ejecución en paralelo no requiere una reescritura masiva. Cuatro pasos, en orden:
- Gestión estatal de auditoría. Reemplace los campos estáticos y los controladores compartidos con hilos.safe Patrones: Inyección de dependencias para Cucumber, Hilo local para Selenium/Appium, aislado Contexto del navegador instancias para Playwright. Confirme que los dispositivos y las instancias del navegador se limpian correctamente entre sesiones.
- Equilibrar la carga de trabajo. Utilice el historial de duración de las pruebas de su sistema de integración continua para distribuir las pruebas más pesadas con antelación, de modo que todos los trabajadores terminen aproximadamente al mismo tiempo en lugar de que un solo trabajador soporte toda la carga.
- Poner en cuarentena y luego ampliar gradualmente la escala. Etiqueta las pruebas frágiles o con limitaciones de velocidad para que se ejecuten secuencialmente. Comienza con un número reducido de procesos paralelos, corrige cualquier condición de carrera que surja y luego amplía la escala.
- Validar e iterar. Monitorea la tasa de falsos fallos y el tiempo de compilación a medida que escalas. Una tasa de repetición de ejecuciones decreciente es una buena señal de que el conjunto de pruebas está mejorando, no solo volviéndose más rápido.
- Mirando hacia el futuro: De guardián a facilitador de la velocidad
Mirando hacia el futuro: De guardián a facilitador de la velocidad
Durante años, el control de calidad fue visto como el guardián final: el equipo que retrasaba los lanzamientos mientras las suites automatizadas procesaban lentamente sus scripts. La percepción era que las pruebas ralentizado Ingenieria.
Al corregir la arquitectura subyacente de su conjunto de pruebas (datos de prueba aislados, subprocesos)safe La gestión de sesiones en Selenium, Playwright o Appium, y los dispositivos debidamente limpios en su cuadrícula de prueba), las pruebas paralelas pueden transformar esa percepción. Un conjunto que antes tardaba horas puede devolver comentarios fiables en minutos, una vez que se ha realizado. safe para funcionar a gran escala.
El futuro de las pruebas no se trata solo de ejecutar más pruebas más rápido. Se trata de ejecutarlas correctamente—con aislamiento, entornos limpios y confianza en los resultados.
Referencias y lecturas adicionales
- Digital.ai Pruebas: Pruebas paralelas – Mejores prácticas: orientación oficial sobre métodos de prueba independientes, evitando variables estáticas, paralelismo y registro, y subprocesos.safe Gestión de controladores para Appium.
- Guía para desarrolladores sobre la generación de datos sintéticos y entornos de prueba autolimpiables.: creación de entornos de prueba efímeros y autolimpiables con datos sintéticos.
- Ngo, K., Nguyen, V., & Nguyen, T. (2022). “Investigación sobre la inestabilidad de las pruebas: de las pruebas unitarias a las pruebas de sistema”. 37.ª Conferencia Internacional IEEE/ACM sobre Ingeniería de Software Automatizada (ASE '22). Una revisión bibliográfica que clasifica las pruebas inestables según su origen: basadas en la prueba, en el entorno y en el producto, y que analiza las herramientas académicas e industriales para detectarlas y repararlas.
- Documentación de Selenium WebDriver: documentación oficial de Selenium sobre sesiones de controlador y automatización del navegador.
- Selenium: Navegador nuevo por prueba: Guía oficial de Selenium sobre prácticas de aislamiento de pruebas.
- Dramaturgo: Aislamiento (Contextos del navegador): documentación oficial sobre cómo Playwright utiliza BrowserContext para el aislamiento de pruebas.
- La pirámide de pruebas: La obra de referencia fundamental de Martin Fowler sobre el aislamiento de pruebas y la granularidad del alcance.
- Digital.ai Pruebas: Plataforma en la nube escalable para pruebas móviles y web en múltiples navegadores: infraestructura empresarial para la ejecución en paralelo en dispositivos y navegadores iOS/Android reales.
También puede interesarle
Cómo crear productos preparados para recibir soporte: lecciones aprendidas de problemas reales de los clientes.
Son las 2 de la madrugada en algún lugar del mundo, y es un momento de liberación…
Pruebas paralelas bien hechas: por qué falla tu pipeline (y cómo solucionarlo)
Todo probador de control de calidad conoce la sensación aplastante de ver un...
Marcos de automatización más allá de Appium y Selenium
Un equipo lanza una aplicación React Native y una campaña de marketing…