公開日:11、2026
AIテスト失敗における信頼性の問題
Stack Overflowの2025年開発者調査によると開発者の84%がワークフローでAIツールを使用している、または使用する予定だと回答しており、これは前年の76%から増加している。同じ調査では、46%がこれらのツールが生成する情報の正確性を積極的に信用していないと回答したのに対し、信用していると回答したのは33%だった。
採用率は上昇したが、同時に信頼度は低下した。
それは位相の問題ではありません。それは、熟練した多くの人々がツールを十分に長い期間使用して調整した結果起こる現象です。
信頼のパラドックスは合理的な反応である
Googleの2025年DORA この報告書は、別の角度から見ても同様の傾向を示している。開発者の80%以上がAIによって生産性が向上したと回答した一方で、30%はAIが生成するコードへの信頼度が低い、あるいは全くないと回答した。有用性と信頼性の低さは必ずしも相反するものではなく、開発者は両方に価値を置いている。
最も経験豊富な人ほど、最も懐疑的である。 Stack Overflowのデータによると、経験豊富な開発者ほど、高い信頼度を示す割合が低く、高い不信感を示す割合が高いことが示されています。これは注目すべき点です。なぜなら、エンジニアリング組織に提示されるあらゆるAI機能を評価するのは彼らであり、自信満々な回答では納得しないからです。
故障解析は、安易な懐疑主義が高騰する原因となる。
開発者のワークフローにおけるAIの多くは、検証のリスクが低い。コードの提案が間違っていたとしても、すぐに判明し、コストはわずか数分だ。
テスト失敗時のトリアージは、そのような単純なものではありません。何かが失敗した場合、問題となるのは何が壊れたかだけでなく、どのレイヤー(アプリケーション、自動化スクリプト、デバイス、環境)が壊れたかです。その答えによって、誰が作業を引き受けるかが決まります。間違えると、数分を無駄にするだけでなく、欠陥を間違ったチームに割り当て、1サイクルを費やし、1日を無駄にして失敗を元の場所に戻してしまうことになります。
兆候は既に現れている。 失敗の原因を説明するために必要なものはすべて実行時に記録されます。スクリプト、デバイスログ、サーバー側のログなど、アプリが停止するまでに記録したあらゆる情報です。証拠は失われていません。失われているのは分析です。そのため、記録されたデータを開き、重要な数百行を選別して貼り付けるのは、依然として人間の手に委ねられているのです。
ソフトウェアがその分析を行うのであれば、「大体正しい」というレベル以上の基準が求められる。信頼できるものでなければならない。問題はモデルの精度ではなく、システムがその分析結果を十分に分かりやすく提示し、ユーザー自身が判断できるかどうかだ。
信頼度スコアは証拠を測定するものであるべきである
AI製品における信頼度スコアの多くは、間違ったものを測定している。それは、モデルがどれだけ確信を持って聞こえるかという点だ。言語モデルは、確信を持って聞こえるようにするのが非常に得意だ。その数値は、答えが正しいかどうかではなく、どれだけ流暢であるかを示しているに過ぎない。
より良いスコアは、証拠に基づいて算出されます。複数の異なる情報源が同じ障害を示している場合、スコアは上昇するはずです。タイムアウトに基づく推測ではなく、実際のエラーメッセージが表示され、障害発生の原因から最終的な故障に至るまでの一連の流れを追跡できる場合にも、スコアは上昇するはずです。
ログソースが欠落している場合、結論を裏付けるソースが1つしかない場合、または他の説明を排除できない場合は、ダウンするべきである。
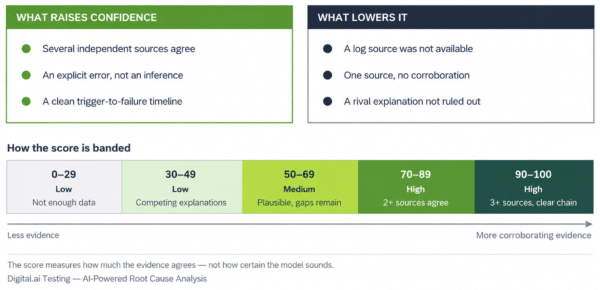
信頼性を裏付けの尺度として捉える――何がスコアを押し上げ、何がスコアを押し下げ、バンドがどのように読み取られるか。
重要なのは、その数字が下がるかどうかだ。
信頼度が低いと報告しない採点システムは、単なる飾り物だ。 すべての分析結果が高ければ、スコアは何も測定していないことになります。真のスコアは、データが少ない場合に低下します。ログソースが欠落している場合は、その欠落を埋めるのではなく、その旨を表示します。
ツールが「確信が持てない」と表示する画面をデモしたい人は誰もいません。しかし、エンジニアたちは、それが実際の調査の進め方と一致すると考えているのです。分からないことを認めるツールは、そのツールに限界があることを示しており、その限界内であれば信頼できるということです。
私たちを含め、あらゆるベンダーに尋ねるべき3つの質問
テスト自動化分野のベンダーは皆、自社のAIが障害の原因を説明できると主張している。しかし、その主張自体が差別化要因となるわけではない。差別化要因となるのは、それを裏付ける証拠だ。以下の3つの質問で、ベンダー間の明確な違いが明らかになる。
- 「分析が間違っていた場合、どうすればそれに気づけるのでしょうか?」 唯一の回答が「ご自身で調査する」である場合、ツールは調査を保存したのではなく、調査に手順を追加したことになります。
- 「信頼度の低い結果を見せてください。」 厳選されたものではありません。デモ環境で低い評価を受けた項目が何もなければ、作成するには何が必要か尋ねてください。
- 「分析結果には実際何が書かれていたのですか?」 これが最も重要な点であり、汎用モデルにログを貼り付けるだけでは限界がある理由です。そのモデルは、誰かがエクスポートできたデータしか認識できません。分析は入力データによって制約されるため、入力データが何であったかを把握しておく必要があります。
シフト
テストにおけるAIの有用性に関する問いは変化しており、AIに求められる役割も変化している。そもそも、エンジニアを意思決定から排除することが目的ではなかった。レイヤーの命名は重大な結果を伴う判断であり、その判断こそが人間が行うべき部分なのである。
人間が行うべきではないのは、文書の読解作業だ。文書を開き、重要な数百行を特定し、その順序を再構築する作業は、ソフトウェアが担うべきである。そうすれば、意思決定者は証拠を収集するのに午後を費やすのではなく、既に収集された証拠に基づいて判断を下すことができる。
だからこそ、スコアの低下は重要なのです。ログソースが欠落していたために信頼度が低下するということは、システムが判断を差し戻していることを意味します。つまり、この件については人間の介入が必要なのです。そうしないツールは、人間が関与する仕組みになっていないということです。誰もチェックしないことを願っているだけなのです。
誰も、モデルが信頼できると説明されたからといって信頼するわけではない。人々が信頼するのは、自分で判断できるだけの十分な情報が提示されたからである。
これが、私たちが構築するものとどのように結びつくのか。 AIを活用した根本原因分析 Digital.ai テスト機能は、実行時の成果物からiOSとAndroidにおけるAppiumテストの失敗を分析し、考えられる原因、証拠の一致度に基づいて算出された信頼度スコア、およびその原因となった特定のログ行またはステップを返します。データが少ない場合、信頼度スコアは低下します。これは意図的な動作です。
出典と参考文献
スタックオーバーフロー 2025年開発者調査 - AIセクション — AIツールを使用している、または使用する予定の人は84%で、76%から増加。AIの出力の正確性を信用していない人は46%で、信用している人は33%。最も経験豊富な開発者の間で不信感が最も高く(「非常に信用していない」が20.7%)。
Google Cloud / DORA、 2025年におけるAI支援型ソフトウェア開発の現状 ― 80%以上がAIによって生産性が向上したと回答している一方、30%はAIが生成したコードに対する信頼度が低い、あるいは全くないと回答している。
お勧めの関連ガジェット